
Mall för dataklassning vid AI-användning
En dataklassningsmall hjälper företag att avgöra vilken information som får användas i AI-verktyg, vilken miljö som krävs och när mänsklig eller juridisk granskning behövs innan arbetssättet införs.
Ladda ner mallen
Nedladdningsbar mall/exempelfil som motsvarar artikeln. Word-dokumentet är redigerbart, kompakt formaterat och har en logotyp som enkelt kan bytas ut mot er egen.
Dataklassning är första skyddsräcket för AI
AI-frågan börjar ofta med verktyg: ChatGPT, Copilot, Claude, Perplexity, Notion AI eller en branschspecifik tjänst. Men för ett företag är den viktigare startpunkten nästan alltid informationen. Vad är det medarbetaren vill mata in, sammanfatta, översätta, analysera eller återanvända?
När ni klassar informationen först blir beslutet mer praktiskt. Öppen information kan ofta hanteras med enklare regler. Intern information kräver ägare och godkänd miljö. Kunddata, personuppgifter, avtal, HR-material och säkerhetsrelaterad information kräver tydligare stoppregler, avtal, loggning och granskning.
Det här gör dataklassning till en vardagsrutin, inte en säkerhetsövning vid sidan av. Medarbetaren ska snabbt kunna förstå om AI-stödet är okej, behöver godkännande eller ska stoppas.
Mallen bör vara enkel nog att användas i vardagen
En dataklassningsmall för AI behöver inte vara juridiskt tung för att fungera. Den ska hjälpa teamet att fatta samma typ av beslut varje gång: vilken datanivå handlar det om, vilket AI-verktyg är godkänt för nivån, vilken kontroll krävs och vem äger undantag?
Börja med fyra nivåer. Öppen information är sådant ni kan publicera eller redan har publicerat. Intern information är arbetsmaterial, rutiner och interna sammanfattningar. Kund- och personrelaterad information kräver dataskydds- och avtalskontroll. Känslig eller affärskritisk information ska normalt inte användas i öppna AI-tjänster utan särskild bedömning.
- Beskriv nivåerna med exempel från er egen verksamhet.
- Ange vilka verktyg som är tillåtna per nivå.
- Skriv vad som måste anonymiseras, maskas eller utelämnas.
- Sätt en tydlig stoppregel för osäker data.
- Koppla återkommande användning till AI-registret.
Kontrollmodellen: från data till beslut
Stödgrafiken visar hur klassningen bör leda till ett beslut innan prompten skrivs. Poängen är att medarbetaren inte ska behöva gissa i stunden.
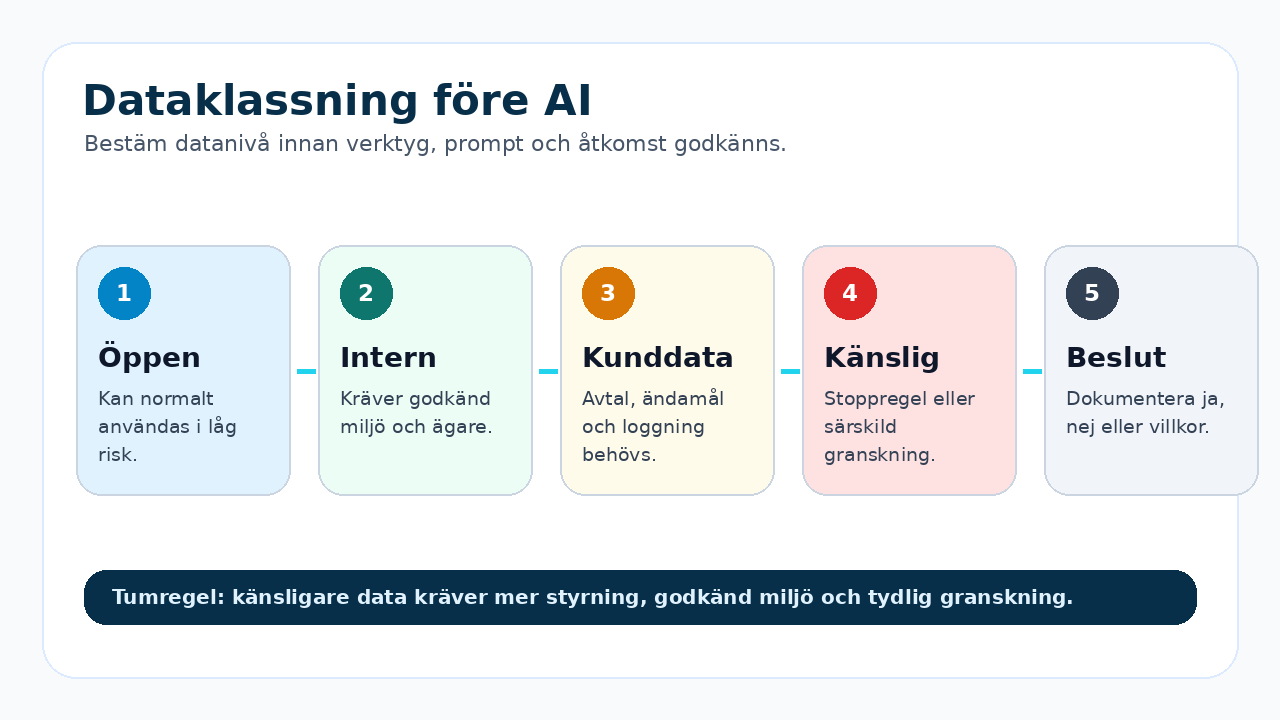
Dataklassning före AI – använd modellen i policyarbete, onboarding och AI-registergenomgång.
Exempel: samma AI-uppgift kan få olika svar
Tänk att en medarbetare vill använda AI för att sammanfatta kundfeedback. Om feedbacken redan är anonymiserad och samlad på en övergripande nivå kan det vara ett låg- eller medelriskflöde. Om samma text innehåller namn, kontaktuppgifter, ärendenummer, hälsouppgifter, klagomål eller detaljer om avtal blir riskbilden en annan.
Samma sak gäller interna dokument. En publik produktbeskrivning kan användas för att skapa ett första utkast till FAQ. Ett internt strategidokument, en incidentrapport eller en uppsägningsrelaterad HR-text kräver däremot en annan miljö och tydligare granskning. Dataklassningen gör skillnaden synlig innan informationen lämnar rätt sammanhang.
Vad ska dokumenteras i AI-registret?
| Fält | Exempel | Varför det behövs |
|---|---|---|
| Syfte | Sammanfatta anonymiserad kundfeedback | Visar varför AI används och vilken nytta som förväntas. |
| Dataklass | Intern, kunddata eller känslig/personrelaterad data | Styr verktyg, avtal, åtkomst och granskning. |
| Godkänd miljö | Företagskonto, avtalad AI-tjänst eller förbjuden miljö | Minskar risken för okontrollerad datadelning. |
| Ägare | Processägare, IT, dataskydd eller verksamhetschef | Någon behöver följa upp ändringar, incidenter och undantag. |
| Kontroll | Anonymisering, mänsklig granskning, loggning, stoppregel | Gör användningen möjlig att revidera och förbättra. |
Vanliga misstag när företag börjar med dataklassning för AI
Om klassningen blir för detaljerad slutar medarbetare använda den. Börja enkelt och bygg på vid behov.
En licens säger inte att alla datatyper passar i verktyget. Datagränsen måste vara tydlig.
Osäkra fall behöver en väg framåt. Annars skapas skugg-AI eller onödiga stopp.
Dataklassning måste synas i AI-registret, utbildning och stickprov för att få effekt.
Viktigt om personuppgifter och reglerade miljöer
Den här guiden är praktisk information och inte juridisk rådgivning. Om AI-användningen omfattar personuppgifter, känsliga uppgifter, sekretess, patientdata, klientdata eller automatiserade beslut bör dataskydd, juridik och informationssäkerhet kopplas in tidigt.
Relaterade guider
Vad är ett AI-register? · AI-policy · AI-säkerhet för företag · Mallar för AI-styrning
Ladda ner AI-registermall
Samla verktyg, syfte, dataklass, ägare, risk och granskning på ett ställe så att AI-användningen blir möjlig att följa upp.
Källor och vidare läsning
IMY om AI och dataskydd · IMY om grundläggande dataskyddsprinciper · NIST AI Risk Management Framework · EU-kommissionen om AI Act